Componentes clave de un superordenador moderno para IA

Los superordenadores llevan mucho tiempo siendo los grandes depredadores del mundo de las TI, pero, al igual que ocurre en la naturaleza, la tecnología no deja de evolucionar.


Sponsored by HPE New Logo

Edge-to-cloud: diseñado para transformar tu negocio. Descubre más aquí.


Hay pocos nombres, si es que hay alguno, que tengan tanto peso en la historia de la supercomputación como Cray. El Cray-1, presentado en 1975, está considerado uno de los superordenadores más emblemáticos de la historia, gracias a innovaciones tecnológicas sorprendentes, como su sistema de refrigeración líquida, y a su enorme éxito comercial. Cray siguió ampliando los límites de la supercomputación, especialmente con el Cray-2 en 1985, que introdujo la refrigeración por inmersión en líquido para la computación de alto rendimiento.

A medida que el panorama de la informática fue cambiando y los superordenadores evolucionaron hacia arquitecturas masivamente paralelas, el dominio que Cray había disfrutado durante las décadas de 1970 y 1980 empezó a disminuir. Aunque la compañía se adaptó para competir en este nuevo mundo de procesamiento masivamente paralelo, pasó a ser uno de los muchos actores del sector.

Todo cambió en 2019, cuando Hewlett Packard Enterprise adquirió Cray por 1.300 millones de dólares. La compañía se convirtió en el motor de las ambiciones de HPE en el ámbito de la supercomputación. Hoy, los tres superordenadores más potentes del mundo son sistemas HPE Cray Supercomputing EX, y seis de los diez primeros puestos están ocupados por máquinas HPE Cray. Sin embargo, el liderazgo de HPE en supercomputación va mucho más allá de los diez primeros puestos, como demuestran las cifras de la última clasificación de los 100 superordenadores más potentes del mundo.

Actualmente, los sistemas HPE Cray SC EX ofrecen:

  • El 55 % de la potencia de cálculo total de los 100 superordenadores más potentes del mundo.
  • El 60 % del total de núcleos de aceleración/GPU de los 100 superordenadores más potentes del mundo.
  • El 70 % de la potencia de cálculo total de los 100 superordenadores con mayor eficiencia energética del mundo.

Se puede afirmar que, con HPE, Cray ha recuperado su posición de liderazgo. Sin embargo, los superordenadores HPE Cray SC EX actuales poco tienen que ver con el Cray-1 de 1975.

La era de la exaescala

Es difícil hacerse una idea del crecimiento exponencial de la potencia de cálculo que hemos experimentado a lo largo de las décadas, pero algunos hitos han sido más importantes que otros. El más reciente ha sido la computación a exaescala: superordenadores capaces de alcanzar un rendimiento de un exaflop.

Un exaflop equivale a un trillón (1.000.000.000.000.000.000) de operaciones de coma flotante por segundo. Para ponerlo en perspectiva, el Cray-1 podía realizar 150 millones de operaciones de coma flotante por segundo. Harían falta más de 6.000 millones de superordenadores Cray-1, colocados uno junto a otro y dando 437 vueltas a la Tierra, para alcanzar ese mismo nivel de potencia.

En 2022, HPE instaló el superordenador Frontier en el Laboratorio Nacional de Oak Ridge del Departamento de Energía de Estados Unidos, en Tennessee. No solo se convirtió inmediatamente en el superordenador más rápido del mundo, sino que también fue el primero en alcanzar y acreditar un rendimiento de exaescala, con 1,1 exaflops.

Frontier era «un sistema sin precedentes» que «beneficiaría a la humanidad», afirmó Justin Hotard, vicepresidente ejecutivo y director general de HPC e IA de HPE. Se trataba de un superordenador «concebido por tecnólogos, científicos e investigadores para abrir una nueva dimensión de capacidades y hacer posibles avances en ciencia abierta, IA y otros campos».

Sin embargo, aunque Frontier fue el primer superordenador de exaescala del mundo, no mantuvo durante mucho tiempo el título de más rápido. En 2024, HPE construyó el superordenador El Capitan para la Administración Nacional de Seguridad Nuclear (NNSA) y el Laboratorio Nacional Lawrence Livermore (LLNL). A pesar de que el rendimiento de Frontier aumentó con el tiempo hasta alcanzar los 1,353 exaflops, los 1,742 exaflops de El Capitan le situaron en el primer puesto con una ventaja considerable. En términos de sistemas Cray-1, esto equivale a 11.600 millones.

La computación a exaescala no consiste únicamente en cifras y clasificaciones. Estos extraordinarios niveles de potencia de cálculo permiten ampliar los límites de la IA en numerosos campos, desde el descubrimiento de fármacos hasta la lucha contra el cambio climático.

Por supuesto, alcanzar el hito de la exaescala no fue fácil. Y aunque los tres superordenadores más rápidos del mundo pueden ofrecer actualmente un rendimiento superior a un exaflop, resulta muy significativo que los tres hayan sido construidos por HPE.

El Capitan supercomputer
El superordenador El Capitan cuenta con más de 11.000 nodos de computación y es 22 veces más potente que el equipo al que sustituye (imagen: Garry McLeod/LLNL)

Anatomía de un superordenador

El éxito de HPE en el ámbito de la supercomputación se basa en un principio similar al que impulsó a Cray décadas atrás: entender que cada uno de los componentes de un superordenador debe ofrecer el máximo rendimiento posible. En un entorno en el que se utilizan miles y miles de nodos de computación, la conectividad y la velocidad del almacenamiento de datos son tan importantes como los procesadores encargados de realizar los cálculos.

Esto no significa que los procesadores no sean importantes; todo lo contrario. Ahora que las cargas de trabajo de IA se han sumado a los modelos y simulaciones tradicionales y al análisis de datos de alto rendimiento dentro del ámbito de la computación de alto rendimiento (HPC), su papel es más importante que nunca. Los potentes núcleos de CPU siempre serán la base de cualquier plataforma de supercomputación, como lo han sido hasta ahora. Pero los núcleos de CPU por sí solos no son suficientes: ahora se complementan con aceleradores basados en GPU igualmente potentes. Estos proporcionan la extraordinaria capacidad de procesamiento de datos que necesitan los científicos de datos y las aplicaciones de IA.

Ambos componentes de esta ecuación de procesamiento necesitan memoria ultrarrápida y de baja latencia, con suficiente ancho de banda para evitar que se desaprovechen ciclos de procesamiento.

Para El Capitan, HPE utilizó las unidades de procesamiento acelerado (APU) AMD Instinct MI300A, que integran núcleos de CPU, aceleradores GPU y memoria compartida de gran ancho de banda en un único encapsulado. Esta estrecha integración entre procesamiento y memoria permite recuperar y procesar los datos lo más rápido posible, sin los problemas de latencia o las limitaciones de ancho de banda que supondría una solución de memoria externa al chip.

La evolución del almacenamiento en los superordenadores

Cualquier superordenador procesa enormes cantidades de datos que necesitan almacenarse en sistemas con una capacidad igualmente impresionante. En los primeros años de Cray, esto significaba utilizar discos duros del tamaño de una lavadora, cuya capacidad era una pequeña fracción de la que ofrecen hoy los smartphones modernos. Pero, al igual que el resto de los componentes de la supercomputación, el almacenamiento también ha evolucionado.

Los sistemas de almacenamiento HPE Cray Supercomputing Storage Systems E2000 ofrecen el rendimiento, la rentabilidad y la flexibilidad necesarios para cualquier aplicación de supercomputación. Un único bastidor de almacenamiento puede transferir a los nodos de computación de un superordenador el equivalente a 500 películas de alta definición de larga duración en un solo segundo. Además, puede almacenar el equivalente a más de 1.100 colecciones impresas de la Biblioteca del Congreso de Estados Unidos.

Estas capacidades récord se consiguen de la forma más rentable. Los sistemas HPE Cray SC Storage Systems E2000 incorporan un sistema de archivos de código abierto con asistencia técnica empresarial, aprovechan las ventajas de distintos soportes de almacenamiento (SSD y HDD) sin sufrir sus inconvenientes y se conectan directamente a la red de interconexión que comunica los nodos de computación del superordenador.

En supercomputación, todo gira en torno a la escala: millones de núcleos de computación que extraen petabytes de datos de innumerables unidades de almacenamiento. Para garantizar que el rendimiento de las aplicaciones crezca al mismo ritmo que la infraestructura de hardware, es imprescindible contar con una tecnología de interconexión rápida y robusta.

La tecnología HPE Slingshot Interconnect 400 ofrece el entorno de gran ancho de banda y baja latencia que necesitan las aplicaciones modernas de supercomputación. Permite escalar el rendimiento de las aplicaciones de forma más eficiente que cualquier otra tecnología de interconexión de gran ancho de banda y baja latencia.

La tecnología de interconexión HPE Slingshot fue fundamental para las ambiciones de HPE en materia de computación a exaescala. Esto queda especialmente claro si tenemos en cuenta que El Capitan incorpora 44.544 APU AMD Instinct MI300A, que contienen la impresionante cifra de 1.051.392 núcleos de CPU y 9.988.224 núcleos de GPU, todos ellos conectados a 400 petabytes de datos compartidos dentro de un único sistema de archivos.

Todo bajo control: la refrigeración

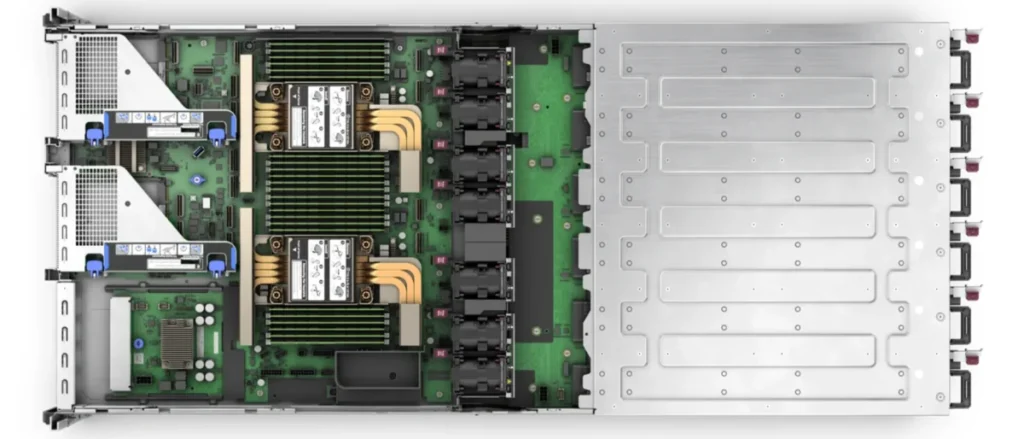
HPE ProLiant Compute XD server
La familia de servidores HPE ProLiant Compute XD está optimizada para el entrenamiento y ajuste de modelos de IA (imagen: HPE)

Hay un efecto secundario inevitable en cualquier forma de computación de alto rendimiento: el calor. Los centros de datos consumen enormes cantidades de energía, y los sistemas de refrigeración requieren una parte considerable de ella, además de la que necesitan los propios procesadores.

Al igual que hizo Cray en la década de 1980, HPE está impulsando una nueva tecnología de refrigeración líquida 100 % sin ventiladores. Su arquitectura de refrigeración líquida directa sin ventiladores ofrece dos ventajas fundamentales. En primer lugar, al eliminar la necesidad del flujo de aire que requieren los sistemas de refrigeración tradicionales, se permite construir sistemas con una mayor densidad de componentes. En otras palabras, se puede concentrar más potencia de procesamiento en cada bastidor, lo que mejora tanto el rendimiento como la rentabilidad. En segundo lugar, la refrigeración líquida directa reduce considerablemente el consumo energético y los costes asociados en comparación con la refrigeración por aire.

«Esta arquitectura de refrigeración líquida directa reduce en un 90 % el consumo energético destinado a la refrigeración en comparación con los sistemas tradicionales refrigerados por aire», afirmó Antonio Neri, presidente y CEO de HPE. Y añadió: «A medida que las organizaciones aprovechan las posibilidades que ofrece la IA generativa, también deben avanzar en sus objetivos de sostenibilidad, hacer frente al aumento de las necesidades energéticas y reducir los costes operativos».

Los superordenadores han cambiado indudablemente en los últimos 50 años, pero su filosofía fundamental sigue siendo la misma: cada componente debe funcionar con la máxima eficiencia para ofrecer el mayor rendimiento posible a nivel de sistema. 

Está por ver qué nos depara la era posterior a la exaescala, pero, a medida que aumenten las necesidades y las aplicaciones de IA, también lo hará el rendimiento del hardware necesario para hacerlas posibles.

Sobre el autor

Foto del avatar
Riyad Emeran

Riyad es un escritor y editor con una amplia trayectoria, que lleva más de 30 años escribiendo sobre el sector tecnológico. En 2003, cofundó y asumió la dirección editorial del sitio web Trusted Reviews. Anteriormente, había sido redactor jefe de la revista Personal Computer World, conocida cariñosamente como PCW.

Ver más artículos de este autor.

Nos tomamos el periodismo en serio. Para saber más sobre por qué puedes confiar en nosotros, visita nuestra Guía editorial o conoce a nuestro equipo.